JVM
JVM组织架构
组织架构组成
类加载器(Class Loader)
运行时数据区(Runtime Data Areas)
执行引擎(Excution Engine)
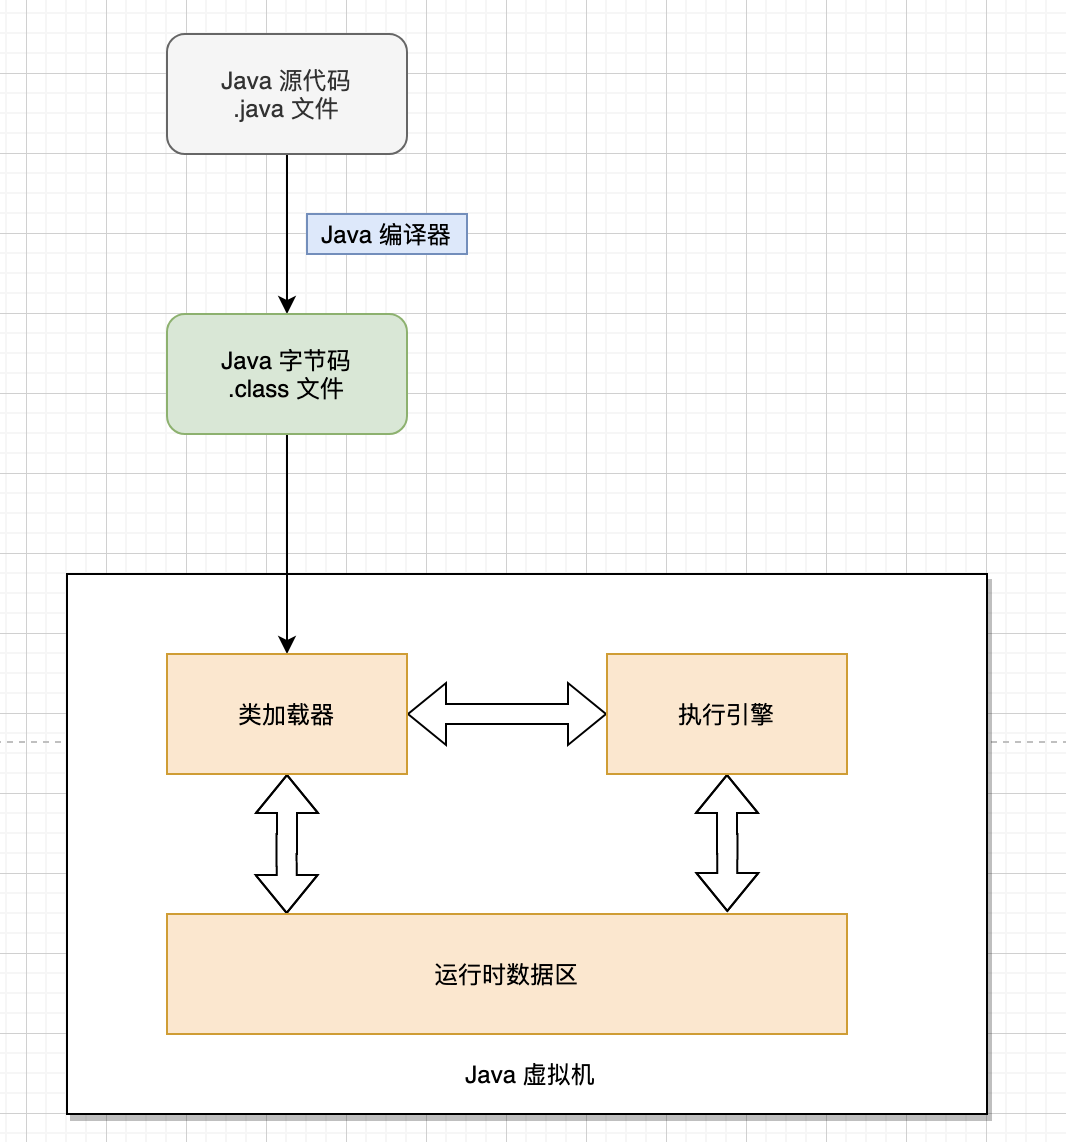
组织架构职责
类加载器
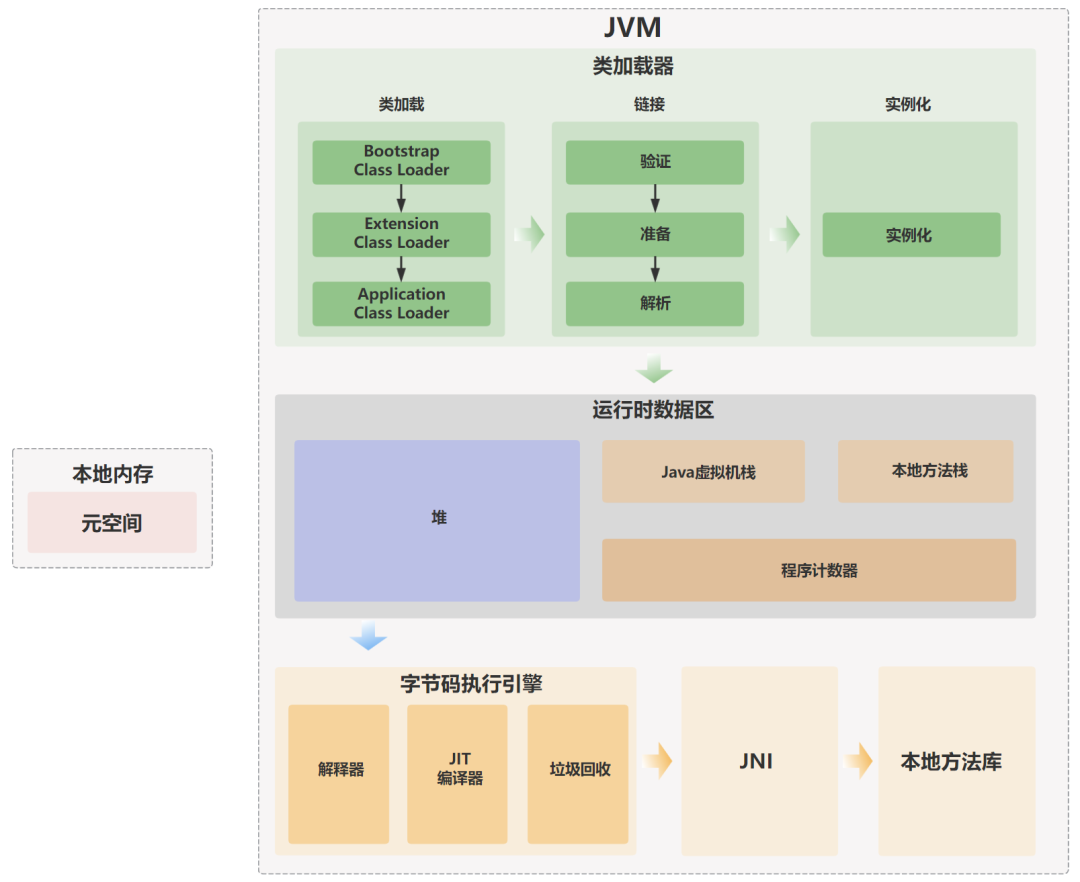
类加载器用来加载类文件(.class文件)。如果类文件加载失败,也就没有运行时数据区和执行引擎什么事了。类加载器负责将字节码文件加载到内存中,主要会经历
加载->链接->实例化这三个阶段
运行时数据区
JVM 定义了 Java 程序运行期间需要使用到的内存区域,简单来说,这块内存区域存放了字节码信息以及程序执行过程的数据,
垃圾收集器也会针对运行时数据区进行对象回收的工作
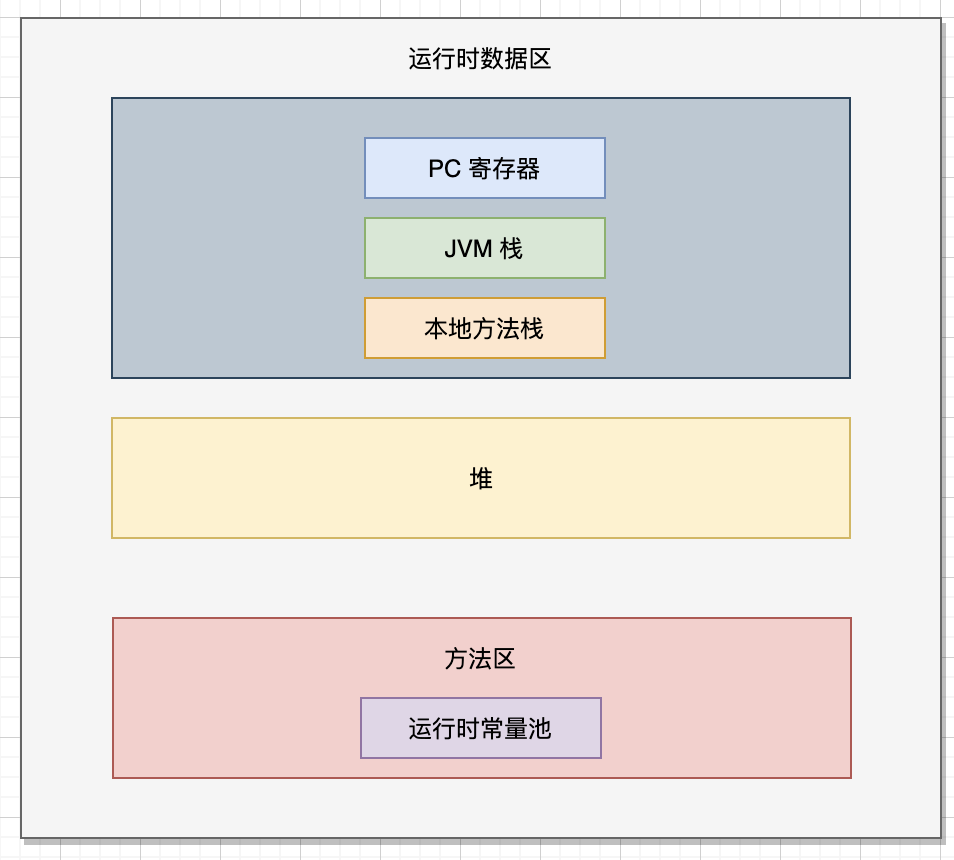
运行时数据区通常包括:
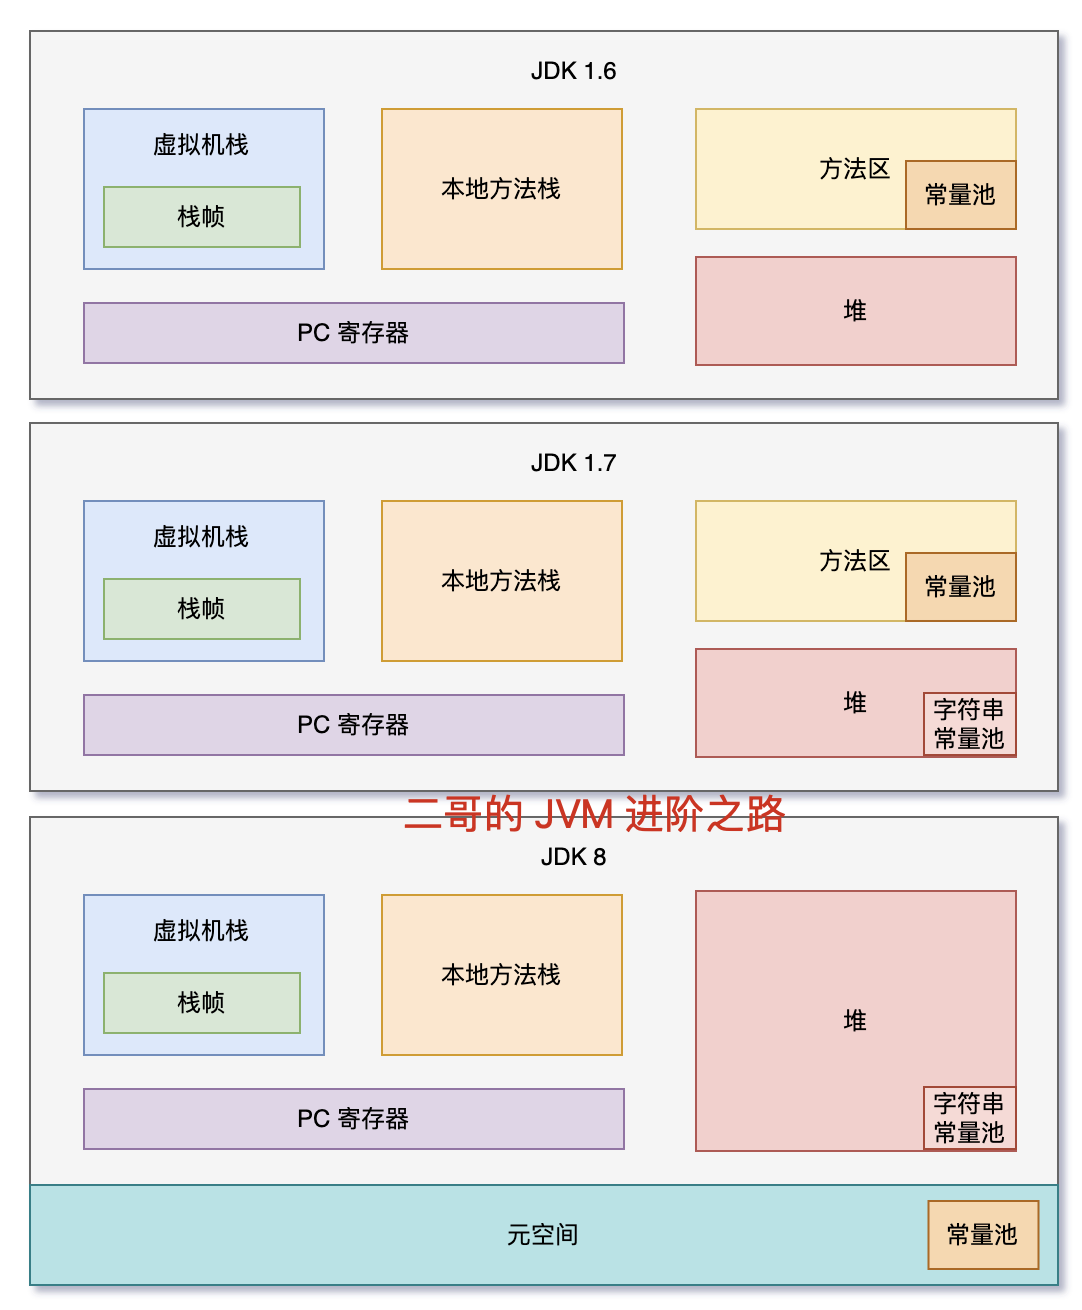
方法区、堆、虚拟机栈、本地方法栈以及程序计数器五个部分。不过,运行时数据区的划分也随着JDK的发展不断变迁,JDK 1.6、JDK 1.7、JDK 1.8 的内存划分都会有所不同。
执行引擎
“虚拟机”是一个相对于“物理机”的概念,这两种机器都有代码执行能力,其区别是物理机的执行引擎是直接建立在处理器、缓存、指令集和操作系统层面上的,而**虚拟机的执行引擎则是由软件自行实现的**,因此可以不受物理条件制约地定制指令集与执行引擎的结构关系,能够执行那些不被硬件直接支持的指令集格式。
执行引擎的任务就是将**字节码指令**解释/编译为对应平台上的本地机器指令才可以。简单来说,JVM 中的执行引擎充当了将高级语言翻译为机器语言的译者。
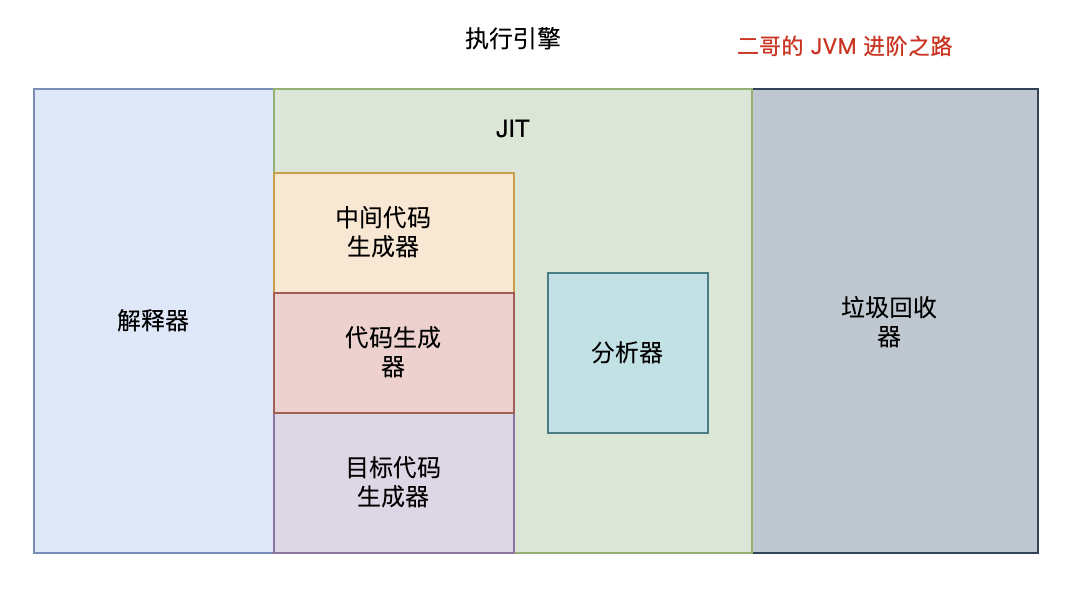
解释器
读取字节码,然后执行指令。因为它是一行一行地解释和执行指令,所以它可以很快地解释字节码,但是执行起来会比较慢(毕竟要一行执行完再执行下一行)
即时编译器
执行引擎首先按照解释执行的方式来执行,随着时间推移,即时编译器会选择性的把一些热点代码编译成本地代码。执行本地代码比一条一条进行解释执行的速度快很多,因为本地代码是保存在缓存里的
垃圾回收器
用来回收堆内存中的垃圾对象
字节码文件结构
字节码文件结构是一组以 8 位为最小单元的十六进制数据流,具体的结构如下图所示,主要包含了魔数、class文件版本、常量池、访问标志、索引、字段表集合、方法表集合以及属性表集合描述数据信息
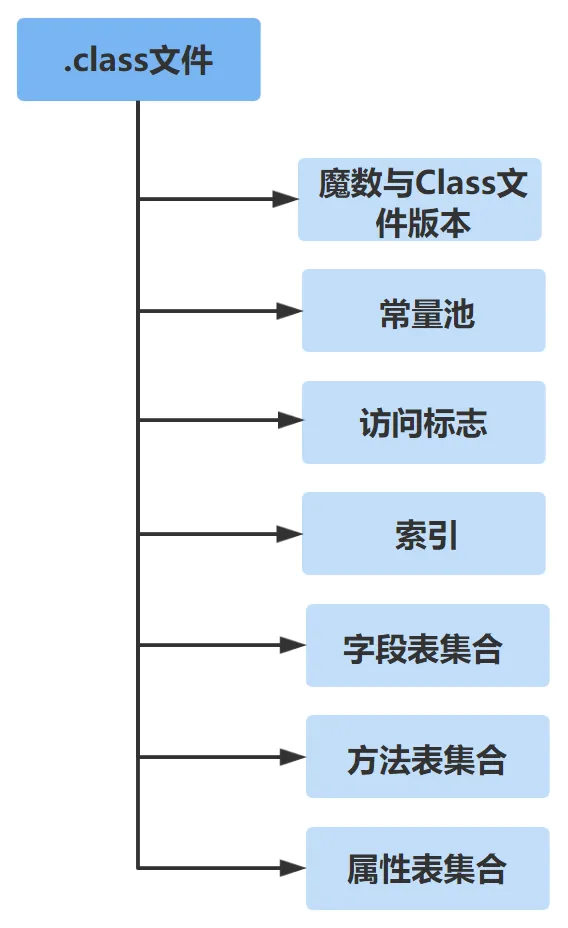
魔数与文件版本
魔数的作用就是告诉JVM自己是一个字节码文件,你JVM快来加载我吧,对于Java字节码文件来说,其魔数为0xCAFEBABE,Java标志=咖啡?
紧随魔数之后的两个字节是文件版本号,Java的版本号通常是以52.0的形式表示,其中高16位表示主版本号,低16位表示次版本号
常量池
主要存放了
字面量以及符号引用这两类常量数据,所谓字面量就是代码中声明为final的常量值,而符号引用主要为类和接口的完全限定名、字段的名称和描述符以及方法的名称以及描述符。常量池的第一个元素是常量池大小,占据两个字节。常量池表的索引从1开始,而不是从0开始,这是因为常量池的第0个位置是用于特殊用途的
访问标志
类或者接口的访问标记,说明类是public还是abstract,用于描述该类的访问级别和属性。访问标志的取值范围是一个16位的二进制数
索引
包含了类索引、父类索引、接口索引数据,主要说明类的继承关系
字段表集合
主要是类级变量而不是方法内部的局部变量
方发表集合
主要用来描述类中有几个方法,每个方法的具体信息,包含了方法访问标识、方法名称索引、方法描述符索引、属性计数器、属性表等信息,总之就是描述方法的基础信息
属性表集合
方法表集合之后是属性表集合,用于描述该类的所有属性。属性表集合包含了所有该类的属性的描述信息,包括属性名称、属性类型、属性值等等
解析字节码文件
JVM解析字节码的过程是将字节码文件中的二进制数据解析为Java虚拟机中的数据结构。
首先JVM首先会读取字节码文件的前四个字节,判断魔数是否为0xCAFEBABE,以此来确认该文件是否是一个有效的Java字节码文件。
JVM接着会解析常量池表,将其中的常量转换为Java虚拟机中的数据结构,例如将字符串常量转换为Java字符串对象。
解析类、接口、字段、方法等信息:JVM会依次解析类索引、父类索引、接口索引集合、字段表集合、方法表集合等信息,将这些信息转换为Java虚拟机中的数据结构。
最后,JVM将解析得到的数据结构组装成一个Java类的结构,并将其放入元空间中。
在完成字节码文件解析之后,接下来就需要类加载器闪亮登场了,类加载器会将类文件加载到JVM内存中,并为该类生成一个Class对象。
类加载
加载器启动
Java应用的类都是通过类加载器加载到运行时数据区的,那么类加载器本身又是被谁加载的呢?
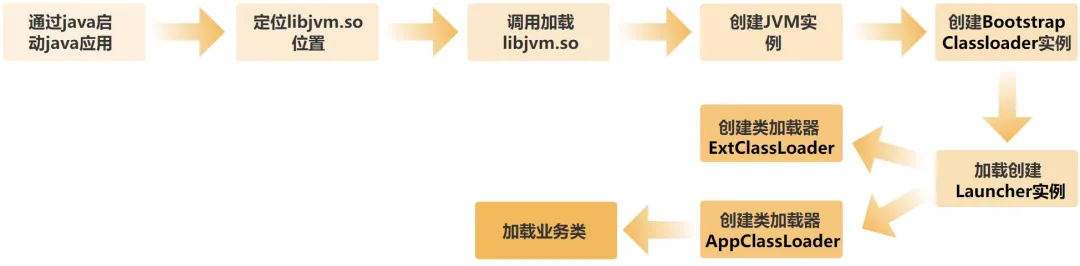
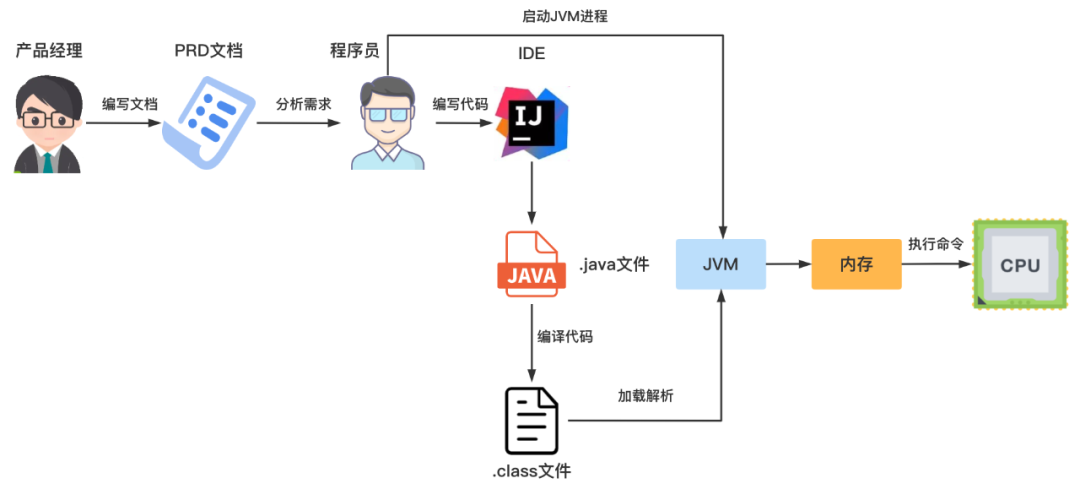
- 以linux系统为例,当我们通过"java"启动一个Java应用的时候,其实就是启动了一个JVM进程实例,此时操作系统会为这个JVM进程实例分配CPU、内存等系统资源
- "java"可执行文件此时就会解析相关的启动参数,主要包括了查找jre路径、各种包的路径以及虚拟机参数等,进而获取定位
libjvm.so位置,通过libjvm.so来启动JVM进程实例- 当JVM启动后会创建引导类加载器
Bootsrap ClassLoader,这个ClassLoader是C++语言实现的,它是最基础的类加载器,没有父类加载器。通过它加载Java应用运行时所需要的基础类,主要包括JAVA_HOME/jre/lib下的rt.jar等基础jar包- 而在rt.jar中包含了
Launcher类,当Launcher类被加载之后,就会触发创建Launcher静态实例对象,而Launcher类的构造函数中,完成了对于ExtClassLoader及AppClassLoader的创建
双亲委派模型
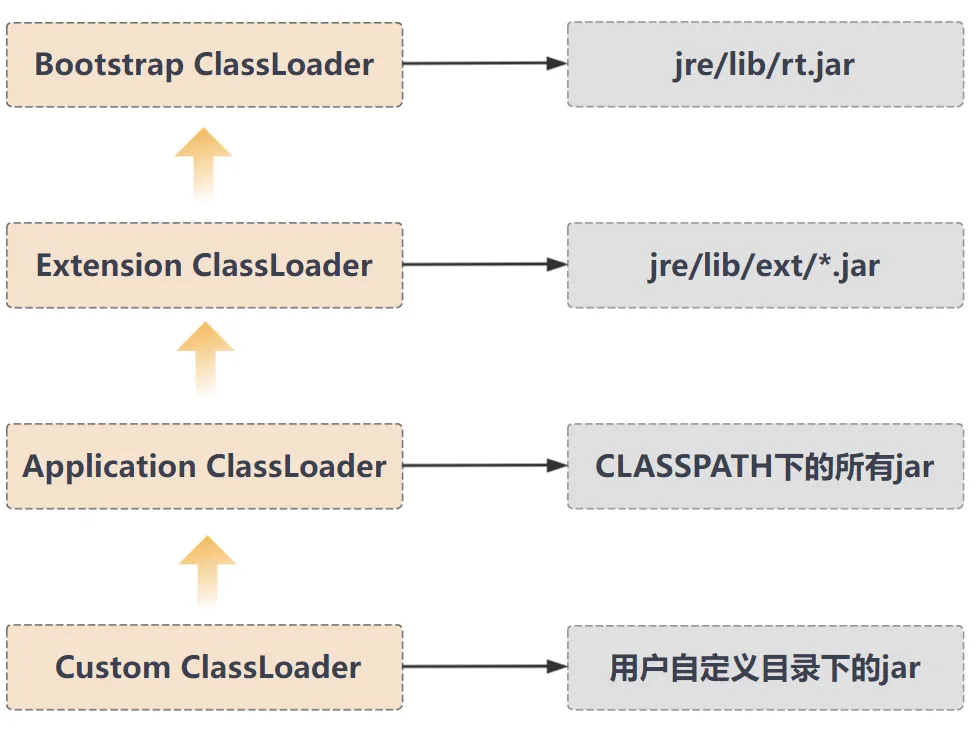
为了保证Java程序的安全性和稳定性,JVM设计了双亲委派模型类加载机制
在双亲委派模型中,
启动类加载器(Bootstrap ClassLoader)、扩展类加载器(Extension ClassLoader)以及应用程序类加载器(Application ClassLoader)按照一个父子关系形成了一个层次结构,其中启动类加载器位于最顶层,应用程序类加载器位于最底层当一个类加载器需要加载一个类时,它首先会委派给它的父类加载器去尝试加载这个类。如果父类加载器能够成功加载这个类,那么就直接返回这个类的Class对象,如果父类加载器无法加载这个类,那么就会交给子类加载器去尝试加载这个类。这个过程会一直持续到顶层的启动类加载器
通过这种双亲委派模型,可以保证同一个类在不同的类加载器中只会被加载一次,从而避免了类的重复加载,也保证了类的唯一性。同时,由于每个类加载器只会加载自己所负责的类,因此可以防止恶意代码的注入和类的篡改,提高了Java程序的安全性
JVM运行Java(字节码指令)
字节码指令序列通常由多条指令组成,每条指令由一个操作码和若干个操作数构成
操作码:一个字节大小的指令,用于表示具体的操作
操作数:跟随操作码,用于提供额外信息
实例:简单指令解析(HelloWorld)
这段字节码序列的意思是调用 System.out.println 方法打印"Hello World"字符串。下面是详细的解释
getstatic、ldc、invokevirtual、return 等就是字节码指令
0 getstatic #2 <java/lang/System.out>
3 ldc #3 <Hello World>
5 invokevirtual #4 <java/io/PrintStream.println>
8 return
0xb2   getstatic       获取静态字段的值
0x12   ldc             常量池中的常量值入栈
0xb6   invokevirtual   运行时方法绑定调用方法
0xb1   return          void 方法返回
①、0: getstatic #2 <java/lang/System.out>:
操作码:getstatic
操作数:#2
描述:这条指令的作用是获取静态字段,这里获取的是java.lang.System类的out静态字段,它是一个PrintStream类型的输出流。#2 是一个指向常量池的索引
②、3: ldc #3 <Hello World>:
操作码:ldc
操作数:#3
描述:这条指令的作用是从常量池中加载一个常量值(字符串"Hello World")到操作数栈顶。#3 是一个指向常量池的索引,常量池里存储了字符串"Hello World"的引用
③、5: invokevirtual #4 <java/io/PrintStream.println>:
操作码:invokevirtual
操作数:#4
描述:这条指令的作用是调用方法。这里调用的是PrintStream类的println方法,用来打印字符串。#4 是一个指向常量池的索引,常量池里存储了java/io/PrintStream.println方法的引用信息
④、8: return:
操作码:return
描述:这条指令的作用是从当前方法返回
运行时内存操作
当
类加载器完成字节码数据加载任务后,JVM 划分了专门的内存区域来装载这些字节码数据以及运行时中间数据其中 PC 寄存器、虚拟机栈以及本地方法栈属于线程私有的,堆以及元空间(方法区的实现)属于共享数据区,不同的线程共享这两部分内存数据
PC寄存器
虚拟机中当前线程执行Java普通方法时:
PC寄存器中存储的是方法的第一条指令,当方法开始执行之后, PC寄存器存储的是下一个字节码指令的地址
虚拟机中当前线程执行native方法时:
PC寄存器中的值为 undefined
执行判断分支、循环、异常等不同的控制转移语句时:
PC寄存器会被置为目标字节码指令的地址(即下一个执行什么,就存什么的字节码指令地址)
执行多线程切换时,虚拟机会记录当前线程的PC寄存器:
线程切换回来时,根据之前记录的值恢复到PC寄存器中,继续执行后续的字节码指令
虚拟机栈
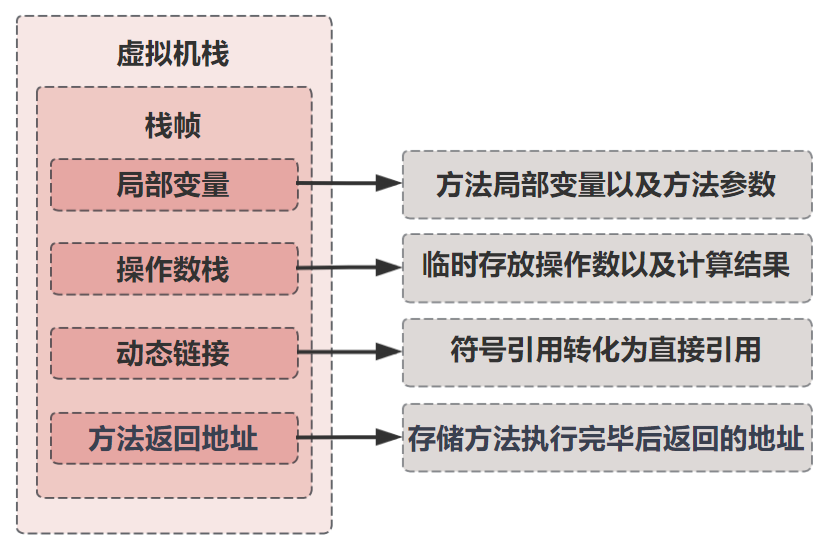
虚拟机栈操作的基本元素就是栈帧,栈帧主要包含了
局部变量表、操作数栈、动态连接以及方法返回地址。栈帧是一个先进后出的数据结构,每个方法从调用到执行完成都会对应一个栈帧在虚拟机栈中入栈和出栈
实例:一个 Test 类,main 方法里 new 了一个 Uesr 对象,会将 User 的 age 作为参数传递给静态方法 calculate 进行一个简单的加法操作并返回,最后打印到控制台
public class Test {
    public static void main(String[] args) {
        User user  = new User();
        Integer result = calculate(user.getAge());
        System.out.println(result);
    }
    private static Integer calculate(Integer age) {
        Integer data = age + 3;
        return data;
    }
}
- JVM 完成 .class 文件加载之后,会创建一个名为"main"的线程,该线程会自动调用名为"main"的静态方法,这是 Java 程序的入口点
- main 线程在执行 mian 方法时,JVM 会在虚拟机栈中压入 main 方法对应的栈帧
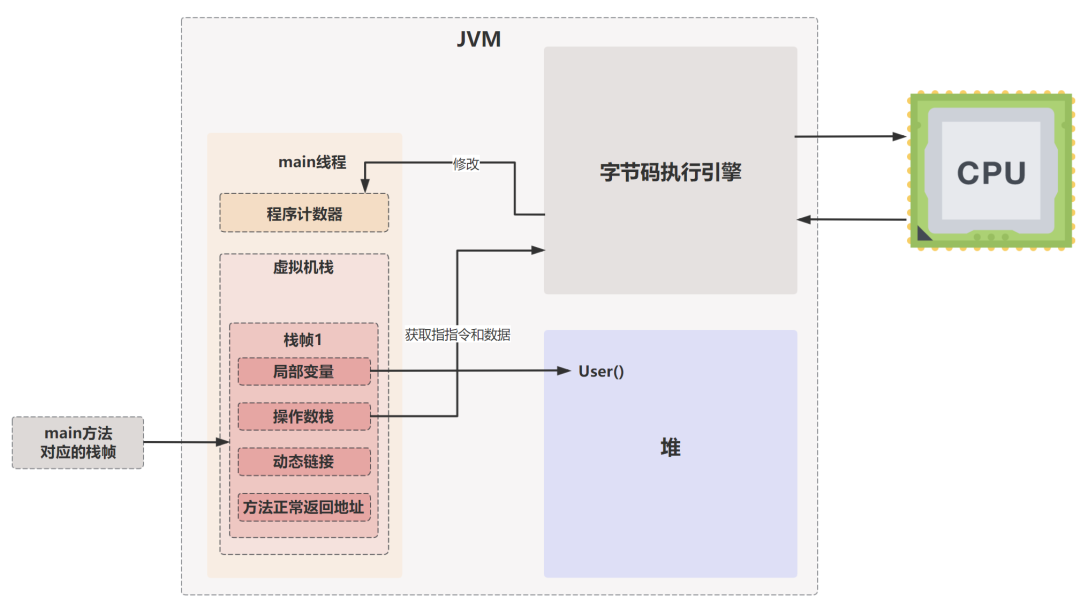
- 栈帧的操作数栈中存储了操作的数据,JVM 执行字节码指令的时候会从操作数栈中获取数据,执行计算操作后会将结果再次压入操作数栈中
- 当进行 calculate 方法调用的时候,虚拟机栈继续压入 calculate 方法对应的栈帧
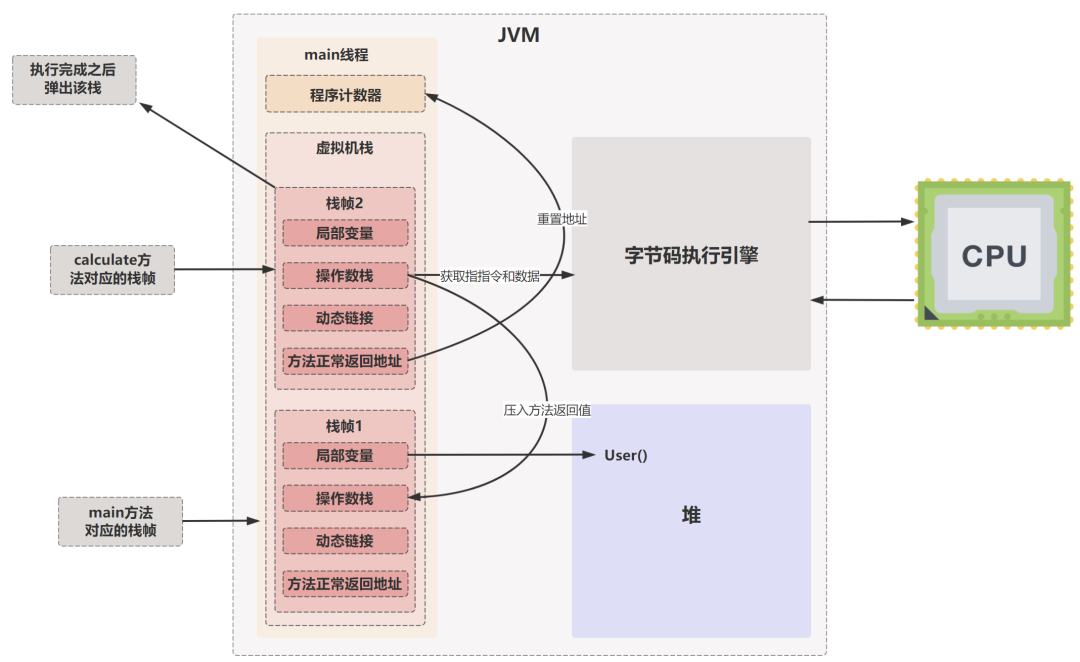
对于 age + 3 这条加法指令,在执行该指令前,JVM 会将操作数栈顶部的两个元素弹出,并将它们相加,然后将结果压入操作数栈中。
在这个例子中,指令的操作码是“add”,它表示执行加法操作;操作数 0,表示从操作数栈的顶部获取第一个操作数;操作数 1,表示从操作数栈的次顶部获取第二个操作数
PC 寄存器中存储了下一条需要执行的字节码指令地址
当 calculate 方法执行完成后,对应的栈帧将从虚拟机栈中弹出,方法执行的结果会被压入 main 栈帧中的操作数栈中,而方法返回地址被重置到 main 线程的 PC 寄存器中,以便于后续字节码执行引擎从 PC 寄存器中获取下一条命令的地址
如果方法没有返回值,JVM 会将一个 null 值压入调用该方法的栈帧的操作数栈中,作为占位符,以便恢复调用方的操作数栈状态
执行引擎中的解释器会从程序计数器中获取下一个字节码指令的地址,也就是元空间中对应的字节码指令,在获取到指令之后,通过解释器解释为对应的机器指令,最终由 CPU 进行执行